Hatoba объединяет SSH-клиент, ИИ-ассистента и зашифрованную синхронизацию
В Hatoba можно поручить ИИ разбор терминала и файлов на удалённом хосте. Клиент поддерживает разные модели, а синхронизация через Cloudflare...

В Hatoba можно поручить ИИ разбор терминала и файлов на удалённом хосте. Клиент поддерживает разные модели, а синхронизация через Cloudflare...
SimulacraBench проверит код моделей на трёх закрытых опросах примерно 40 тысяч человек. Организаторы вернут участникам агрегированную оценку, но такой результат...
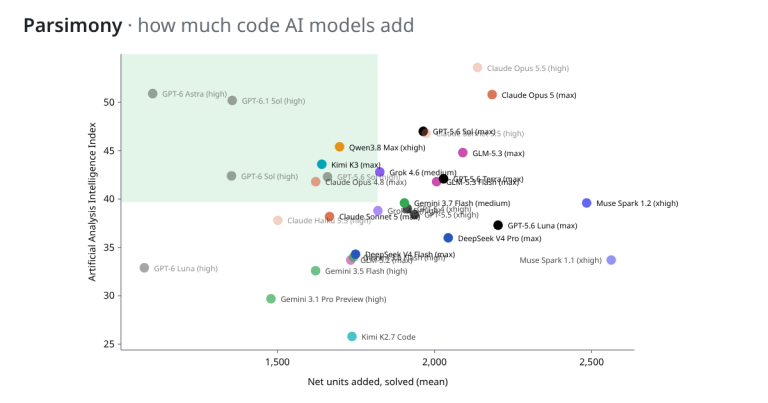
Новый открытый бенчмарк оценивает не только решение задачи, но и чистый объём синтаксических элементов в патчах моделей. Это дополнительный сигнал,...
«Бэкдор» сообщает, что PerPic показывает позу-референс поверх экрана камеры, и перечисляет другие функции приложения. Возможности отдельно не проверялись.
Стартап Consus предлагает единый OpenAI-совместимый интерфейс, который маршрутизирует запросы к инфраструктуре с заданным уровнем соответствия требованиям. По заявлению компании, она...
Автор поста на Reddit предупреждает: делегируя агенту написание кода, разработчики могут сэкономить на наборе, но потерять понимание архитектуры и причин...
Сервис проверяет ответы ChatGPT, Claude, Perplexity и Google AI Overviews на вопросы покупателей, отслеживает упоминания брендов и источники ответов.
Закрывающиеся стартапы начали получать деньги за исходный код, переписки и рабочие документы. Такие архивы интересуют разработчиков ИИ, но их продажа...
В Hacker News обсуждают идею общей базы исправлений, которую AI-агенты могли бы читать и пополнять. Но доступный источник не позволяет...
Исследователи Apple описали способ, при котором агент сам выбирает момент для сжатия длинной истории действий. В статье сообщается о результатах...
OpenAI объявила о MLE-bench — бенчмарке для измерения того, как ИИ-агенты справляются с инженерными задачами в машинном обучении. Одного названия...
В r/artificial обсуждают, готовы ли ИИ-агенты самостоятельно вести сложные задачи. Но исходный пост — приглашение к дискуссии, а не отчёт...