Бенчмарк проверяет выбор API в длинных сценариях магазина
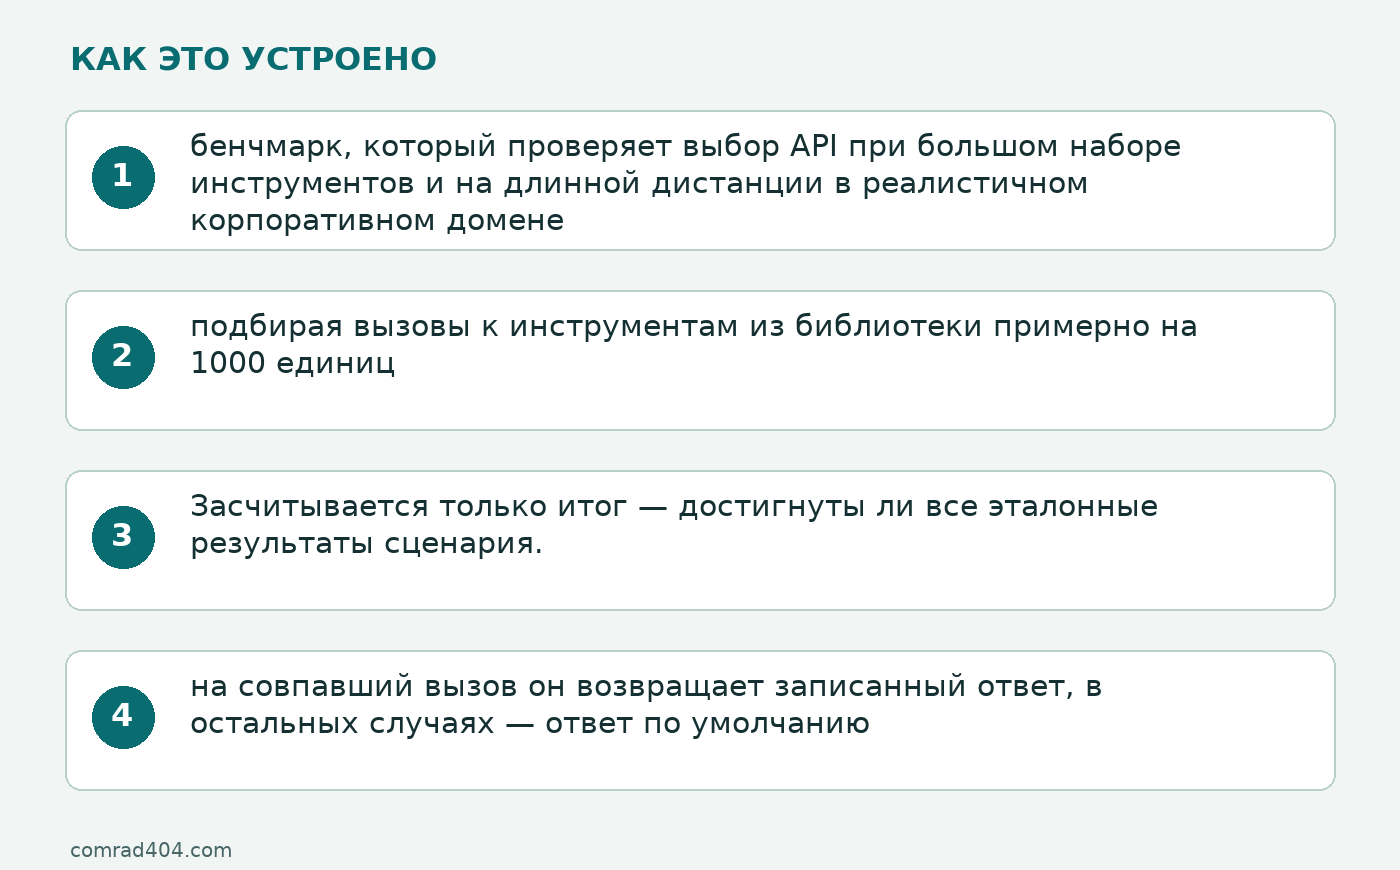
2 ноября 2026 года в arXiv опубликована первая версия препринта SLATE: A Large-Scale Benchmark for Long-Horizon API Selection in E-commerce Tool Use (arXiv:2611.03982v1, cs.CL). По описанию авторов, это бенчмарк, который проверяет выбор API при большом наборе инструментов и на длинной дистанции в реалистичном корпоративном домене; материал — электронная коммерция.
В препринте указан воркшоп «Agentic AI Benchmarks and Applications for Enterprise Tasks», то есть работа адресована корпоративным задачам с агентными системами. Сценарий, вокруг которого построен стенд: пройти операционную процедуру магазина, подбирая вызовы к инструментам из библиотеки примерно на 1000 единиц, а не отвечая одним коротким вызовом. Засчитывается только итог — достигнуты ли все эталонные результаты сценария.
Три части стенда: процедуры, симулятор и метрика по итогу
SLATE расшифровывается как Synthetic Large-scale API Toolkit for E-commerce. Запросы в нём разложены на иерархические процедуры, привязанные к инструментам, поверх библиотеки примерно из 1000 инструментов электронной коммерции. Симулятор детерминированный и контекстно-зависимый: на совпавший вызов он возвращает записанный ответ, в остальных случаях — ответ по умолчанию.
Успех считается по конечному результату: задача решена, когда достигнуты все эталонные исходы. Разные допустимые траектории при этом не отсекаются, а оценка остаётся автоматической и воспроизводимой — так описывают метрику авторы. В препринте сказано, что они выпускают SLATE, его симулятор и обвязку для оценки; в приложениях есть шаблоны промптов, пример данных, детали экспериментов и раздел об ограничениях и этических аспектах. Текст распространяется по лицензии CC BY-NC-SA 4.0 — это условие для самого препринта, а не заявление о лицензии на код стенда.
5,0% задач у лучшей из шести моделей
В экспериментах, описанных в препринте, участвовали шесть открытых decision-моделей и языковые модели, на которых они построены. Лучшая из шести завершила 5,0% задач, и авторы делают из этого вывод, что SLATE — трудный тест для надёжного использования корпоративных инструментов. Знаменатель здесь — задачи бенчмарка, а не обращения к коммерческим ассистентам: пять успешных сценариев на сто задач стенда.
Что стоит за цифрой и где границы
Показатель относится к шести открытым decision-моделям и к стенду, который собрали сами авторы; независимых проверок SLATE в доступных материалах нет. Симулятор отдаёт записанные ответы на совпавшие вызовы и ответы по умолчанию в остальных случаях, поэтому измеряется выбор и компоновка API в смоделированной среде, а не работа с живыми системами магазина. Назван только результат лучшей модели — распределение по остальным пяти в аннотации не приведено, а набор синтетический, так что перенос цифры на реальные корпоративные процедуры авторы не показывают.
Это один авторский препринт. Он задаёт измеримую планку для длинных цепочек выбора API и фиксирует, что оценка идёт по конечному результату задачи, а не по совпадению с эталонной траекторией, — но не доказывает, что 5,0% близко к пределу для всех подходов.