Библиотека для сборки, а не готовый сервер
В README Resin описан как библиотека строительных блоков для инференса больших языковых моделей, а не как готовый inference engine. Проект опубликован в записи Hacker News от 26 октября 2026 года; дата публикации или обновления самого README не указана. README Resin на GitHub пригодится инженерам, которые собирают runtime под новую модель или оборудование, но не тем, кому нужен готовый сервер.
Как Rust Engine связывается с моделью
В основе Resin находится headless Engine на Rust: он планирует работу, управляет KV-кэшем и предоставляет сервер метрик. На вход поступают идентификаторы токенов, после чего Engine формирует замороженный BatchPlan — описание запланированной работы.
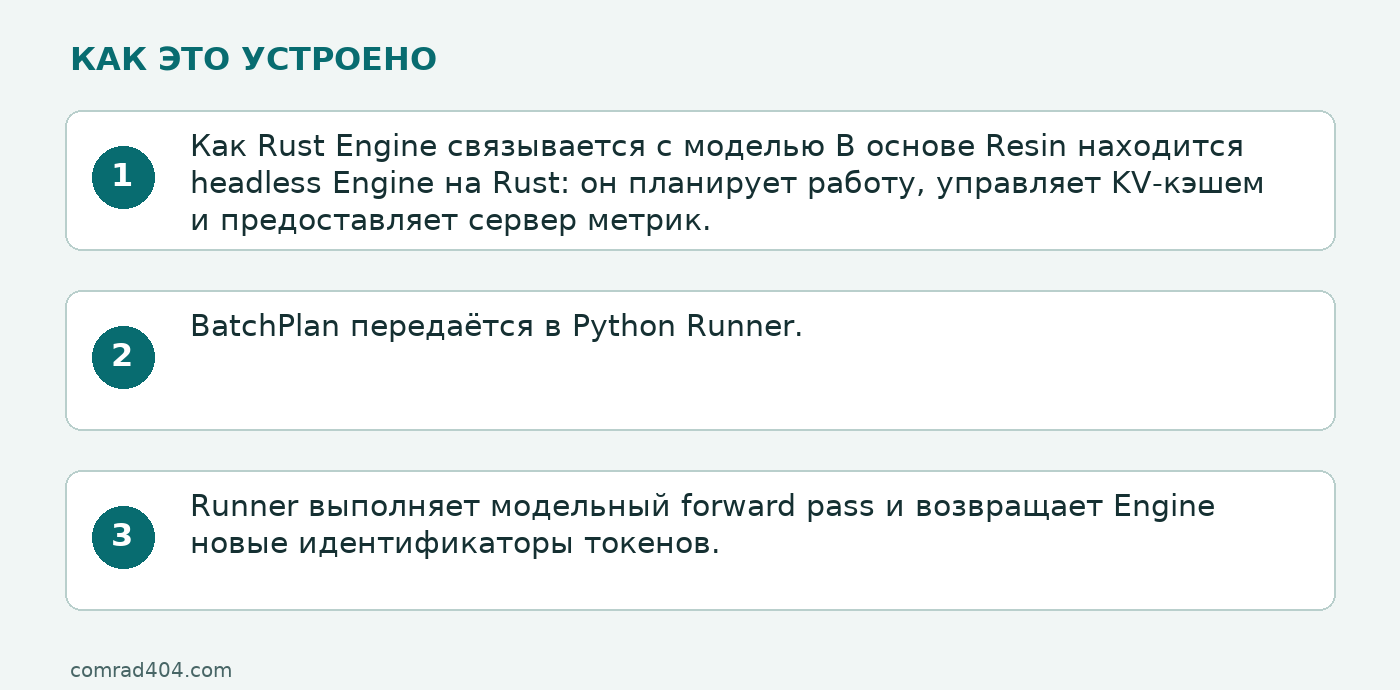
BatchPlan передаётся в Python Runner. Runner выполняет модельный forward pass и возвращает Engine новые идентификаторы токенов. Сам forward pass разработчик должен реализовать в виде ядер, зависящих от модели и оптимизированных под конкретное оборудование. Поэтому Resin отделяет планирование и владение запросами от вычислений, специфичных для модели.
Что заявлено в README
Среди перечисленных возможностей — Rust-планировщик батчей, единый slab-based пул для KV-, SWA- и recurrent-кэшей, speculative decoding с MTP и DSpark, параллелизмы TP, EP, CP и DP Attention, CUDA-графы для prefill и decode, NUMA-привязка процессов и общий кэш ядер. Проект также заявляет опциональные HTTP-сервис и экспорт метрик в Prometheus.
Кому это может пригодиться
README предлагает форкнуть репозиторий либо подключить пакеты Resin и resin_models_cuda отдельно. Для новой модели предусмотрена инструкция add-resin-model, а для оптимизации — рабочий процесс с профилированием и повторными замерами. Для ядра требуются Python 3.11 или новее и Rust; при установке из GitHub Rust-расширение собирается локально.
Такой подход подходит команде, которой нужен контроль над планированием, кэшированием и модельными ядрами, например при создании нового аппаратного backend’а. Для обычного запуска уже поддерживаемой модели он означает дополнительную работу по реализации и оптимизации forward pass.
Заявления о скорости и ограничение проекта
README прямо предупреждает, что Resin не является production-quality software, и рекомендует для практического использования SGLang или vLLM. Разработчик утверждает, что за 12 часов с помощью Resin создал на GPU Blackwell отдельные движки для DeepSeek-V4.1-Flash и GLM-5.3-Flash, сопоставимые с vLLM и SGLang. Для DeepSeek-V4.1-Flash README также заявляет, что показатели prefill и decode находились в пределах 5–10% от DeepInfer. Эти сравнения опубликованы самим разработчиком; независимых тестов в доступном источнике нет, а условия измерений и дата получения результатов не указаны.