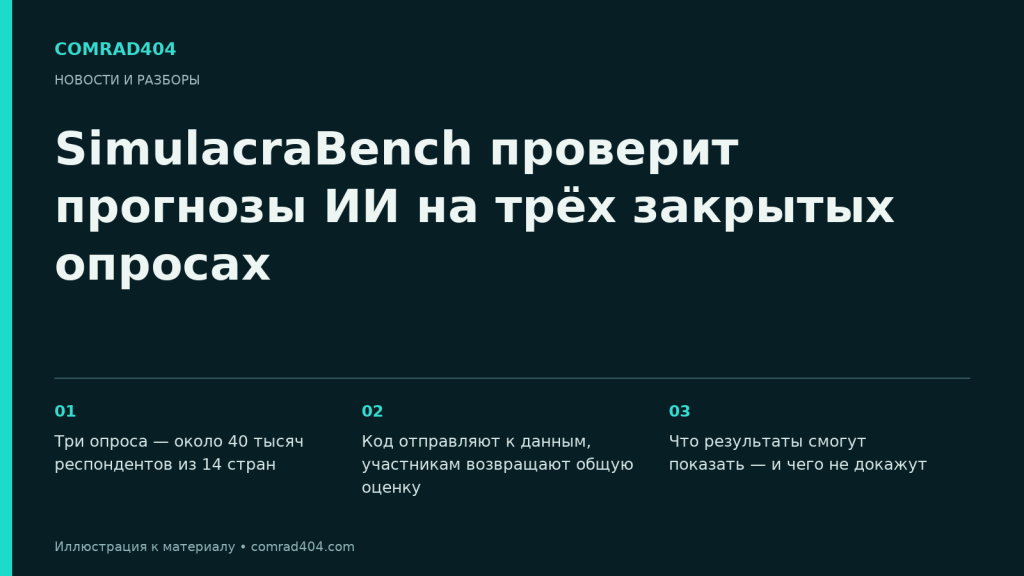
Организаторы SimulacraBench описывают его как соревнование NeurIPS 2026, которое должно проверить представления ИИ о труднодоступных группах на трёх неопубликованных наборах микроданных UNHCR, UNICEF и Всемирного банка. На официальной странице проекта указано, что публичный запуск состоялся 18 августа 2026 года. Результаты участников на проверенном снимке не приведены, поэтому пока речь идёт о заявленной методике, а не о доказанной способности моделей представлять группы населения.
Три опроса — около 40 тысяч респондентов из 14 стран
По данным организаторов, в соревновании используют набор ERPIS для домохозяйств сирийских беженцев в четырёх странах, опрос UNICEF о религиозном влиянии и вакцинации в десяти странах и оценку навыков Всемирного банка для соискателей работы — преимущественно в Южной Африке, а также в Лесото и Нигерии. На странице конкурса указано около 40 тысяч респондентов суммарно: 10 300 в ERPIS, 19 800 в Faith & Immunisation и 6 900 в Skills Assessment. Это характеристики наборов по описанию организаторов, а не независимая оценка их репрезентативности. Состав наборов и описание опросов.
Код отправляют к данным, участникам возвращают общую оценку
Участники передают код, а не готовые прогнозы. Организаторы устанавливают зависимости и запускают код на отложенных ответах без сетевого доступа; сами микроданные участникам не передают. Согласно описанию конкурса, обратно приходит одна агрегированная оценка навыка и время выполнения — без разбивки по отдельным ответам и ячейкам. Правила закрытой оценки SimulacraBench.
Что результаты смогут показать — и чего не докажут
Такая проверка сможет сравнить прогнозы на этих трёх конкретных наборах по правилам конкурса. Но одна итоговая оценка не показывает, где именно модель ошибается, а результат на отдельных опросах сам по себе не доказывает, что ИИ надёжно предсказывает ответы любых людей или может заменить опросы при принятии решений. Организаторы также заявляют, что эти наборы отсутствовали в обучающих данных; независимо проверить это по доступному описанию нельзя. Методика и ограничения, заявленные организаторами.